Llevar un sistema a la nube suena simple: alquilar servidores en AWS en vez de tenerlos en la oficina. En la práctica, lo difícil no es la nube sino el día del cambio: los datos que no pueden quedar a medias, las integraciones con bancos o con la contabilidad, y los usuarios que el lunes tienen que seguir trabajando. Esta guía explica cómo se migra un sistema a la nube por etapas, sin parar la operación, con un caso real de una plataforma de sueldos.
Qué es migrar a la nube (y qué no)
Migrar a la nube es mover un sistema —aplicación, base de datos, archivos e integraciones— de servidores propios a un proveedor como Amazon Web Services (AWS), Azure o Google Cloud, donde se paga por uso y la infraestructura crece o se achica según la demanda.
No es lo mismo que modernizar. Se puede llevar a la nube un sistema viejo tal como está, y se puede modernizar un sistema sin sacarlo de la oficina. Muchas veces conviene hacer las dos cosas, pero conviene saber cuál se está haciendo en cada parte. Si lo que te preocupa es el sistema en sí, empezá por cómo modernizar un sistema legacy sin detener la operación.
Las siete formas de migrar
AWS ordena las opciones en siete estrategias, conocidas como las «7 R». No hace falta elegir una para todo el sistema: cada parte puede ir por un camino distinto.
| Estrategia | Qué es | Cuándo conviene |
|---|---|---|
| Rehospedar | Mover tal cual a servidores en la nube | Hay apuro por salir del servidor propio |
| Reubicar | Mover las máquinas virtuales enteras, sin tocarlas | Ya está todo virtualizado |
| Replataformar | Cambiar sólo algunas piezas por servicios gestionados | La base de datos o los archivos dan trabajo |
| Refactorizar | Rehacer la arquitectura para aprovechar la nube | El sistema no escala o no se puede cambiar |
| Recomprar | Reemplazar por un producto SaaS | Es un proceso estándar, sin reglas propias |
| Retener | Dejarlo donde está, por ahora | Todavía no hay motivo o hay una restricción |
| Retirar | Apagarlo | Ya nadie lo usa |
Rehospedar es lo más rápido, pero se lleva los problemas a la nube y suele costar más de lo esperado. Refactorizar es lo que más valor da, pero lleva más tiempo. Lo habitual es combinar.
Antes de mover nada: inventario y dependencias
La mayoría de las migraciones que fallan no fallan en la nube, fallan por algo que nadie sabía que existía: un proceso nocturno que deja un archivo para el banco, una planilla que lee directo de la base, un usuario que entra por una IP fija. Por eso el primer paso es un inventario de todo lo que el sistema hace y de todo lo que se conecta con él.
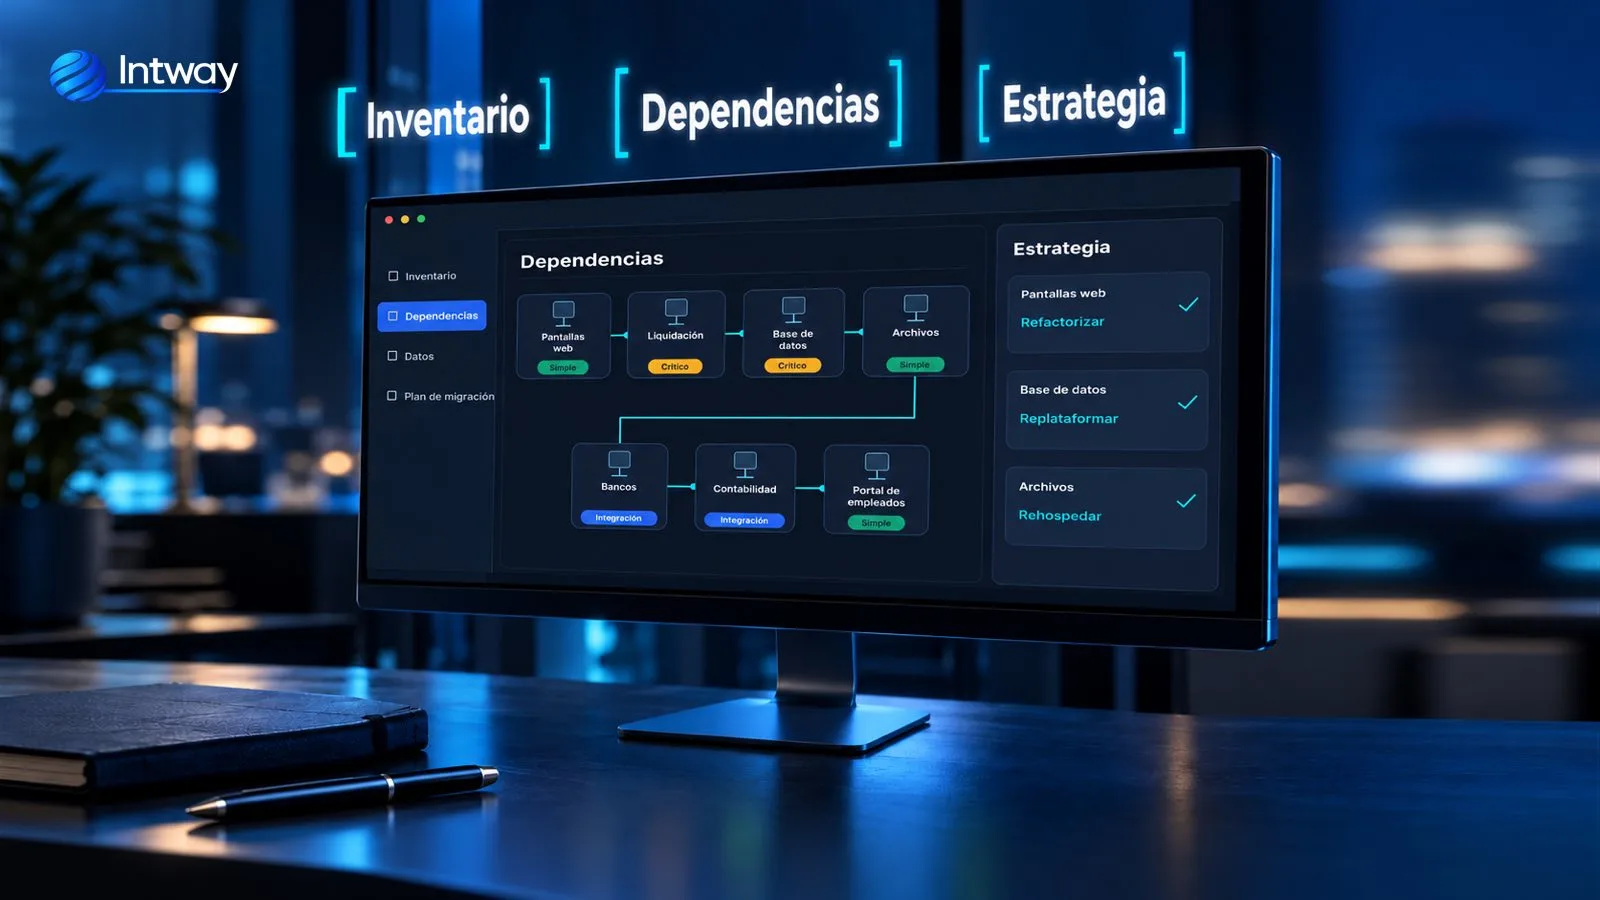
Con ese mapa se decide la estrategia de cada parte y el orden: primero lo que tiene pocas dependencias, al final lo crítico.
Cómo se migra sin parar la operación: cinco pasos
1. Armar la base en la nube como código
Antes de mover el primer dato se arma el terreno: cuentas, redes, permisos, copias de seguridad y monitoreo. Todo se define como infraestructura como código, en archivos versionados. Así cada entorno —pruebas, homologación, producción— es idéntico, y si algo se rompe se vuelve a crear en minutos.
2. Migrar por partes, no todo junto
Se elige un primer grupo chico: un módulo, una sucursal, un país. Se migra, se estabiliza y recién después se sigue con el próximo. Cada etapa es reversible y el riesgo nunca es todo el negocio.
3. Los datos: replicar, no copiar una vez
Copiar la base un viernes a la noche y esperar que alcance el fin de semana es la receta del corte largo. Lo seguro es replicar: la base nueva se carga con todo lo histórico y después recibe en forma continua cada cambio que se hace en la vieja. El día del corte sólo falta lo último, y eso son minutos.
4. Correr los dos sistemas en paralelo
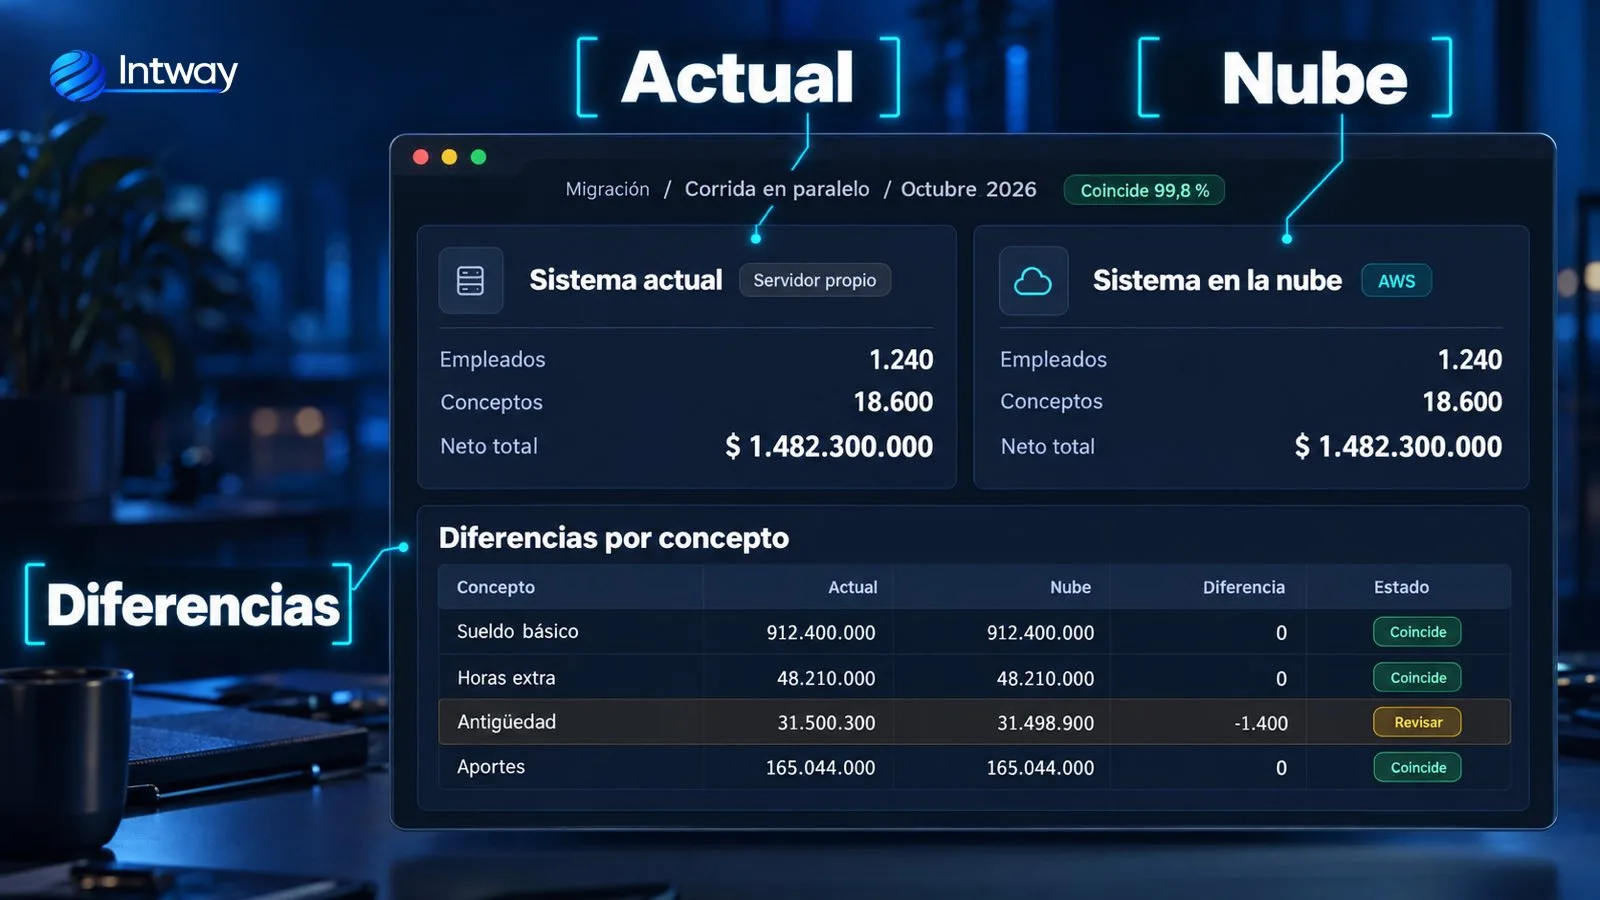
Antes de cambiar, el sistema nuevo procesa los mismos datos que el viejo y se comparan los resultados. Si coinciden, se avanza. Si no, se encuentra la diferencia antes de que la vea un cliente o un empleado.
5. Cortar con vuelta atrás
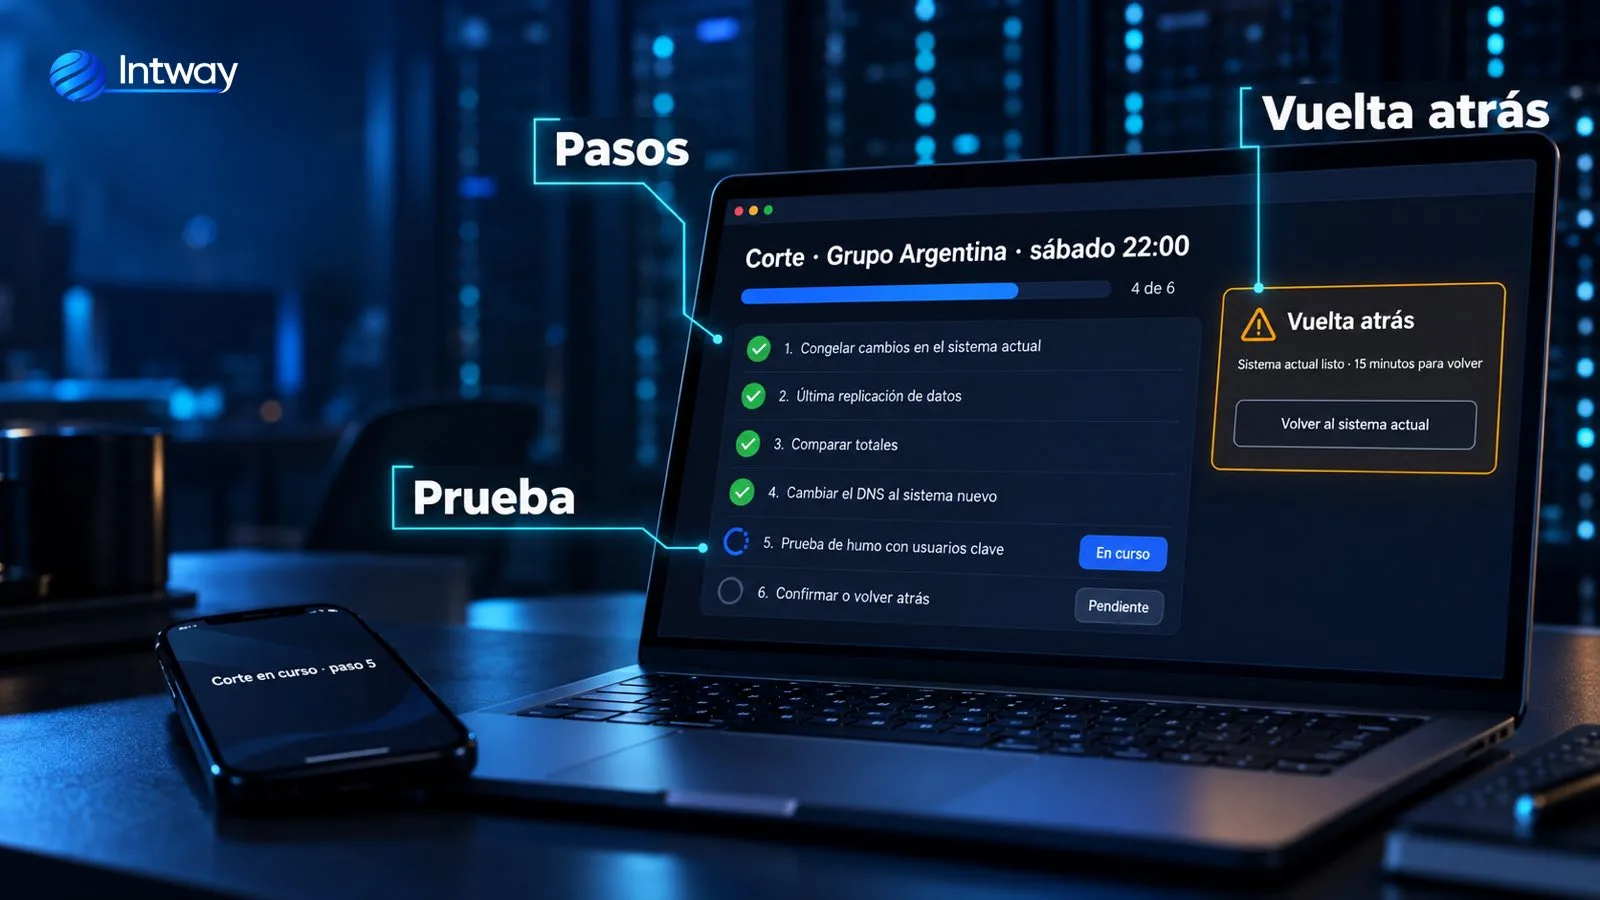
El corte se hace en una ventana acordada, con una lista de pasos escrita y probada antes en homologación. El sistema viejo queda listo para volver durante los primeros días. Si la prueba con usuarios clave falla, se vuelve atrás en minutos y se reintenta otro día, sin drama.
El caso real: un liquidador de sueldos llevado a AWS
En el caso de una plataforma de nómina para Latinoamérica, el sistema tenía el cálculo en Visual Basic, pantallas en ASP Classic y sólo funcionaba con Internet Explorer. Los cierres de sueldos tienen fechas que no se pueden mover, así que parar no era una opción.
- Por capacidades y por país. La migración se organizó por etapas: cada país se habilitaba sólo cuando sus resultados coincidían.
- Corrida en paralelo con datos reales. Con liquidaciones históricas anonimizadas se armó una batería de pruebas que corría los mismos datos en el motor viejo y en el nuevo, y comparaba concepto por concepto.
- Convivencia. Las pantallas nuevas convivieron al principio con funciones viejas a través de una capa de compatibilidad, y se mantuvo una ruta de contingencia durante los primeros cierres.
- Infraestructura como código y despliegues automatizados desde el primer día.
La plataforma quedó en AWS con la web detrás de CloudFront y AWS WAF, las APIs en NestJS, el motor de cálculo en Go escalando en los picos de cierre, colas de Amazon SQS para los trabajos largos, PostgreSQL para los datos y S3 para los documentos. Separar así las piezas es lo que permite que cada una crezca por su cuenta; lo contamos en microservicios.
Costos: lo que nadie mira hasta que llega la factura
La nube puede salir más barata o mucho más cara que el servidor propio. La diferencia está en estas costumbres:
- Ajustar el tamaño de cada servidor a su uso real, medido después de la migración, no al de la máquina vieja.
- Apagar lo que no se usa: los entornos de prueba no necesitan estar prendidos de noche ni los fines de semana.
- Comprometer uso (instancias reservadas o Savings Plans en AWS) sólo para lo que ya es estable.
- Etiquetar cada recurso por sistema y por área, para saber quién gasta qué.
- Alertas de presupuesto desde el primer día, para enterarse de un desvío en horas y no a fin de mes.
Seguridad: qué hace el proveedor y qué te toca a vos
El proveedor cuida los edificios, el hardware y la red de base. Lo que se configura arriba es responsabilidad de la empresa: quién tiene acceso a qué, el cifrado de los datos, las copias de seguridad, las claves y el registro de lo que pasa. Si el sistema maneja datos personales, también hay que revisar en qué país quedan alojados y qué exige la Ley de Protección de Datos Personales.
Errores comunes
- Migrar todo en un solo fin de semana. Si algo falla, falla todo.
- Saltear el inventario. La integración que nadie anotó aparece el lunes.
- Copiar la base una sola vez en lugar de replicarla: alarga el corte y obliga a parar.
- Cortar sin vuelta atrás probada. Un plan de contingencia que nunca se ensayó no es un plan.
- Llevar los servidores con el mismo tamaño y dejarlos prendidos siempre: la factura sorprende.
- Configurar a mano en la consola: después nadie sabe cómo se armó ni puede repetirlo.
Checklist antes de arrancar
- Listá cada parte del sistema y cada cosa que se conecta con él.
- Elegí la estrategia de cada parte: rehospedar, replataformar, refactorizar o retirar.
- Definí el primer grupo chico para migrar y cómo vas a medir que salió bien.
- Armá la base en la nube como código, con copias de seguridad y monitoreo.
- Prepará la replicación de datos y la corrida en paralelo.
- Escribí la lista de pasos del corte, con la vuelta atrás, y ensayala en homologación.
- Activá alertas de presupuesto y etiquetas antes de prender el primer servidor.
Cómo te ayudamos desde Intway
Migramos sistemas a la nube por etapas: relevamos lo que hay, armamos la infraestructura como código, preparamos la replicación y la corrida en paralelo y acompañamos cada corte. Mirá el caso completo del liquidador llevado a AWS, cómo trabajamos como fábrica de software y ampliación de equipos o cómo encaramos un software a medida para pymes.